La fotografia ha vissuto due svolte: il passaggio dalla pellicola al digitale e, subito dopo, una trasformazione radicale dei processi di acquisizione e post-produzione delle immagini. L’introduzione della fotografia computazionale ha segnato una svolta fondamentale in questo percorso evolutivo, integrando sistemi di elaborazione avanzata e algoritmi di intelligenza artificiale per migliorare la qualità, la risoluzione e la gestione delle immagini. Fin dai primi studi sul processamento digitale delle immagini, si è compreso che il semplice scatto non bastava a rappresentare fedelmente la complessità della scena fotografata. La necessità di superare i limiti imposti dalle tecnologie tradizionali ha portato alla sperimentazione di metodi che sfruttassero il potere computazionale per integrare più informazioni visive in un’unica immagine.
In un contesto in cui la capacità di catturare dettagli minuti e di correggere automaticamente errori di esposizione e messa a fuoco rappresentava un notevole vantaggio competitivo, la computational photography ha offerto soluzioni innovative. La fusione tra hardware e software ha permesso di implementare sistemi in grado di combinare più scatti in condizioni diverse, dando vita a tecniche come il bracketing per immagini ad alta gamma dinamica (HDR), la riduzione del rumore e la creazione di effetti di profondità simulata. Queste tecniche si fondano su algoritmi complessi che analizzano ogni pixel, identificano le informazioni mancanti o errate e ricostruiscono l’immagine finale in maniera ottimizzata.
L’evoluzione di questa disciplina si è sviluppata parallelamente all’incremento esponenziale della potenza di calcolo dei dispositivi elettronici. Le prime fotocamere digitali si limitavano a semplici operazioni di acquisizione, ma la rapida evoluzione dei processori e la disponibilità di reti neurali addestrate hanno permesso di elaborare informazioni in tempo reale. Sistemi sofisticati hanno introdotto la possibilità di effettuare operazioni di demosaicing avanzato, miglioramenti dinamici del contrasto e della saturazione, nonché correzioni cromatiche che vanno ben oltre le capacità delle tecnologie analogiche. L’approccio computazionale ha inoltre aperto la strada a tecniche di super-risoluzione, in cui algoritmi specifici aggregano dati provenienti da più scatti per creare un’immagine con una risoluzione superiore a quella originaria del sensore.
Nel corso degli anni, numerosi laboratori di ricerca e aziende leader nel settore della tecnologia hanno investito risorse significative nello sviluppo di software e algoritmi che sfruttassero il potere dell’intelligenza artificiale. Questa branca della tecnologia ha permesso di applicare modelli di apprendimento profondo per riconoscere schemi complessi nelle immagini, migliorare la precisione della messa a fuoco automatica e persino interpretare il contenuto semantico delle scene. La capacità dei sistemi di apprendere da grandi quantità di dati ha condotto a miglioramenti sostanziali nella qualità dell’immagine, garantendo al contempo una gestione automatica dei parametri tecnici durante il processo di acquisizione.
L’interazione tra le tecnologie tradizionali e quelle computazionali ha dato vita a una nuova era nella fotografia, in cui l’immagine, un tempo frutto di un’istantanea sola, è oggi il prodotto di un’elaborazione complessa che coinvolge la fusione di informazioni provenienti da diverse fonti. Questo paradigma ha rivoluzionato il modo in cui vengono concepiti i flussi di lavoro fotografici, con sistemi che integrano dati provenienti da sensori multipli e che utilizzano algoritmi di machine learning per ottimizzare la resa finale. La capacità di eseguire queste operazioni in tempo reale ha reso possibile l’adozione di tecniche computazionali anche in ambiti professionali dove la rapidità e la precisione sono requisiti imprescindibili.
Le innovazioni introdotte dalla fotografia computazionale hanno avuto un impatto profondo anche sulla gestione dei file digitali. Le immagini, una volta acquisite, possono essere sottoposte a operazioni di elaborazione che ne migliorano la qualità e ne correggono eventuali difetti. Sistemi di correzione automatica del rumore digitale, algoritmi per il miglioramento del contrasto e la rimozione di aberrazioni ottiche sono solo alcuni degli strumenti che oggi fanno parte del processo di post-produzione. Tali operazioni si basano su una combinazione di metodi statistici e modelli di rete neurale, capaci di riconoscere e correggere anomalie che, in passato, richiedevano un intervento manuale da parte di esperti. Questa evoluzione tecnica ha consentito di ottenere immagini con una fedeltà e una qualità precedentemente inimmaginabili, aprendo nuove possibilità creative e applicative per il fotografo moderno.
La convergenza tra hardware e software rappresenta un elemento chiave di questa trasformazione. I moderni sensori, dotati di elevata sensibilità e risoluzione, lavorano in sinergia con processori dedicati e algoritmi specializzati che elaborano le informazioni in maniera istantanea. Il risultato è una fotografia che registra la luce e subito dopo la interpreta, la adatta e la perfeziona in base a modelli matematici e statistiche predittive. Questa sinergia ha portato alla nascita di nuove tipologie di dispositivi, in cui l’intelligenza artificiale è il centro stesso del processo di acquisizione e di elaborazione dell’immagine. La trasformazione dei dati grezzi in un’immagine finita e ottimizzata rappresenta un salto qualitativo che ha cambiato la pratica fotografica e, con essa, la percezione stessa dell’immagine come documento storico e artistico.
Questo articolo guarda alla fotografia computazionale con occhio editoriale: meno schede tecniche, più domande su che cosa significhi chiamare «fotografia» un’immagine costruita da un algoritmo. Per la parte pratica, dai principi di funzionamento ai flussi di lavoro con le reti neurali, esiste una guida gemella: fotografia computazionale e AI, come l’intelligenza artificiale ridefinisce l’immagine. Qui contano i fatti aggiornati a ottobre 2026 e le conseguenze per chi scatta e per chi guarda.
In Sintesi
- La fotografia computazionale fonde più fotogrammi e li interpreta con reti neurali: l’HDR+ di Google, descritto nel 2016, unisce una raffica di scatti sottoesposti partendo dai dati raw.
- La super-risoluzione multi-frame, presentata con il Pixel 3 nel 2018, sfrutta il tremolio naturale della mano e può fare a meno del demosaicing.
- Nel 2026 la sfida si gioca sul sensore e sull’obiettivo: iPhone 18 Pro con apertura variabile, Galaxy S26 Ultra con sensore da 200 megapixel, Pixel 11 con chip Tensor G6.
- La provenienza delle immagini è il nuovo fronte: Content Credentials C2PA sui Pixel 10 e obblighi di trasparenza dell’AI Act dal 2 agosto 2026.
- Il fotografo conserva il controllo con il formato RAW e le modalità professionali, anche se alcune elaborazioni non si possono spegnere.
- Una foto computazionale resta una fotografia, ma il «momento» è ormai una finestra di tempo fusa da un software.
Fondamenti tecnici e intelligenza artificiale applicata all’immagine
La fotografia computazionale si fonda su una serie di principi tecnici che si intrecciano con le capacità offerte dall’intelligenza artificiale. Uno degli aspetti più rilevanti è il modo in cui i dati vengono acquisiti, elaborati e reinterpretati per migliorare la qualità finale dell’immagine. Al centro di questo processo vi è l’uso di sensori digitali ad alta risoluzione, che sono in grado di catturare una vasta gamma di informazioni visive, dalla luminosità ai dettagli cromatici più sottili. Queste informazioni vengono poi trasmesse a processori dotati di architetture specifiche per l’elaborazione parallela, capaci di gestire enormi quantità di dati in tempo reale.
Il flusso di lavoro tipico di una fotocamera computazionale inizia con la cattura dei dati grezzi, spesso memorizzati in un formato RAW, che preserva ogni informazione registrata dal sensore. I file RAW rappresentano una base fondamentale per l’applicazione degli algoritmi di elaborazione dell’immagine, poiché consentono una flessibilità notevole in fase di post-produzione. Questi file, pur essendo di dimensioni considerevoli, contengono dati ancora quasi privi di elaborazione, che permettono di effettuare operazioni di miglioramento, come la correzione della distorsione ottica, l’ottimizzazione del bilanciamento del bianco e la regolazione dell’esposizione.
Una volta acquisiti, i dati vengono elaborati da algoritmi che sfruttano tecniche di deep learning e reti neurali convoluzionali (CNN). Questi algoritmi sono stati addestrati su vasti dataset di immagini, che permettono loro di riconoscere pattern e di correggere difetti comuni come il rumore digitale, le aberrazioni ottiche e le distorsioni di colore. La capacità delle CNN di identificare caratteristiche complesse in un’immagine consente di applicare correzioni specifiche a livello di singolo pixel, portando a una resa visiva estremamente accurata. La precisione di tali algoritmi ha permesso di ridurre significativamente la dipendenza da interventi manuali, rendendo il processo di post-elaborazione molto più efficiente e standardizzato.
Un altro aspetto riguarda la fusione di informazioni di natura diversa. Una fotocamera ordinaria registra la luce visibile e scarta infrarosso e ultravioletto con filtri dedicati, ma gli smartphone attuali combinano più obiettivi e sensori di profondità o di distanza. Queste informazioni aggiuntive possono essere integrate in un processo di fusione dei dati, che consente di creare immagini con una ricchezza di dettagli e una profondità di informazione superiore a quella ottenibile con tecniche tradizionali. L’impiego di algoritmi per la fusione dei dati si basa su modelli matematici complessi che bilanciano le diverse sorgenti di informazione, ottimizzando la resa visiva e garantendo una rappresentazione fedele della scena originale.
La computational photography sfrutta anche tecniche avanzate per il miglioramento dinamico dell’immagine. Tecniche come il bracketing per immagini ad alta gamma dinamica (HDR) permettono di catturare più esposizioni della stessa scena e di combinare le informazioni in un’unica immagine che evidenzia dettagli nelle zone scure e chiare. Google ha scelto una strada diversa con l’HDR+, descritto nel 2016 da Hasinoff e colleghi: una raffica di fotogrammi tutti sottoesposti, allineati e fusi a partire dai dati raw, perché sommare molti scatti scuri riduce il rumore senza bruciare le alte luci. Il processo di fusione HDR richiede algoritmi in grado di bilanciare i livelli di luce e di gestire in modo accurato la transizione tra le diverse esposizioni, mantenendo una coerenza cromatica e una nitidezza ottimale. Questa operazione, che in passato richiedeva tecniche laboriose e manuali, oggi si effettua in maniera automatizzata grazie all’impiego di intelligenza artificiale e sistemi di elaborazione parallela.
Il controllo della qualità dell’immagine passa anche per il riconoscimento semantico della scena. Algoritmi di object detection e segmentazione semantica analizzano il contenuto visivo per identificare soggetti, sfondi e oggetti, consentendo un’ottimizzazione mirata dei parametri fotografici. Questa capacità di interpretare il contenuto della scena permette di applicare correzioni personalizzate, migliorando la resa complessiva dell’immagine in funzione del contesto. La tecnologia, dunque, corregge gli errori tecnici e insieme adatta l’elaborazione alle caratteristiche di ciascuna fotografia. Il sistema può sbagliare, naturalmente: un cielo scambiato per un muro o una pelle levigata oltre il lecito sono difetti noti di questi sistemi.
Il potenziale di questi sistemi è reso ancora più evidente dalla capacità di eseguire elaborazioni in tempo reale, una caratteristica fondamentale per le applicazioni mobile e per le fotocamere integrate negli smartphone. La combinazione di hardware dedicato, come i processori grafici e i chip di intelligenza artificiale, con algoritmi altamente ottimizzati, consente di ottenere risultati straordinari con tempi di latenza estremamente ridotti. Questa combinazione ha cambiato il modo di fotografare, permettendo di realizzare immagini di qualità professionale in ambienti e condizioni che un tempo erano considerati proibitivi.
Il livello di precisione tecnica raggiunto dai moderni sistemi di fotografia computazionale si riflette anche nelle possibilità di personalizzazione offerte agli operatori. Le impostazioni automatiche, integrate con opzioni manuali avanzate, permettono di intervenire direttamente sui parametri di elaborazione, adattando il flusso di lavoro alle esigenze specifiche del fotografo. Questo grado di controllo, unito alla potenza dei sistemi di elaborazione basati su AI, crea un ecosistema in cui la creatività e la tecnologia si fondono per dare vita a immagini che catturano il momento e ne offrono una lettura personale.
Algoritmi avanzati e tecniche di elaborazione dell’immagine
Il nucleo della fotografia computazionale risiede negli algoritmi che gestiscono e migliorano le immagini. Questi algoritmi, frutto di anni di ricerca in ambito matematico e informatico, rappresentano il motore che permette di trasformare i dati grezzi in fotografie di alta qualità. L’elaborazione digitale delle immagini coinvolge una serie di operazioni complesse che spaziano dalla riduzione del rumore alla correzione della distorsione, passando per l’ottimizzazione del contrasto e la gestione cromatica. Ogni fase del processo richiede una conoscenza approfondita sia delle proprietà fisiche della luce che delle caratteristiche dei sensori digitali.
Le tecniche di demosaicing costituiscono uno degli aspetti fondamentali di questa fase. I sensori delle fotocamere digitali sono spesso dotati di una matrice di filtri colorati, che, sebbene permettano di catturare informazioni cromatiche, richiedono algoritmi sofisticati per ricostruire un’immagine a colori completa. La procedura di demosaicing si basa su metodi interpolativi che analizzano il contesto circostante ogni pixel, ricostruendo le informazioni mancanti attraverso un’analisi statistica dei dati acquisiti. La super-risoluzione multi-frame di Google, presentata con il Pixel 3 nel 2018, ha mostrato che se ne può fare a meno: il tremolio naturale della mano sposta l’immagine di pochi pixel tra un fotogramma e l’altro, così ogni punto riceve un valore di rosso, verde e blu senza interpolazione. Questi metodi, che vanno dai più semplici algoritmi bilineari a quelli basati su reti neurali profonde, sono in continua evoluzione e rappresentano uno degli ambiti di ricerca più attivi nella fotografia digitale.
Le operazioni di High Dynamic Range (HDR) richiedono una gestione accurata di esposizioni multiple, combinate per produrre un’immagine finale che evidenzi dettagli sia nelle aree più luminose che in quelle più scure. L’algoritmo di fusione HDR si basa su una serie di trasformazioni matematiche che bilanciano i livelli di luce, garantendo una transizione graduale e naturale tra le diverse zone di esposizione. Questa tecnica, che ha richiesto anni di perfezionamento, è ora integrata in molti dispositivi grazie a chip dedicati e processori capaci di eseguire complesse operazioni in tempo reale.
Il riconoscimento semantico della scena, basato su algoritmi di deep learning, rappresenta un ulteriore elemento che distingue la fotografia computazionale dai metodi tradizionali. Reti neurali addestrate su enormi dataset sono in grado di identificare soggetti, volti, paesaggi e oggetti, permettendo una segmentazione dettagliata dell’immagine. Questo processo consente di applicare miglioramenti mirati e di adattare il trattamento dell’immagine alle specifiche aree, ottimizzando la resa complessiva e preservando dettagli importanti. La capacità di interpretare il contenuto visivo in maniera automatica ha rivoluzionato il modo in cui viene gestita la post-produzione, rendendo possibile una personalizzazione del flusso di lavoro basata su parametri ottenuti direttamente dall’analisi dell’immagine.
Tecniche come la super-risoluzione e il miglioramento del dettaglio si basano su algoritmi che aggregano informazioni da più scatti, ricostruendo un’immagine con una risoluzione superiore rispetto a quella originaria del sensore. Questi metodi sfruttano la potenza delle reti neurali per riconoscere pattern ricorrenti e per riempire le lacune presenti nei dati acquisiti, producendo immagini estremamente dettagliate e fedeli alla scena reale. La sfida tecnica di questi algoritmi consiste nell’equilibrare la ricostruzione del dettaglio con la prevenzione di artefatti e anomalie, un compito che richiede un’attenta calibrazione dei modelli matematici sottostanti.
L’elaborazione dell’immagine si completa con la gestione del colore, un aspetto di fondamentale importanza per garantire che l’immagine finale rispecchi fedelmente la scena originale. I processi di calibrazione del colore, basati su profili ICC e algoritmi di gestione cromatica, sono in grado di correggere le variazioni introdotte dalla luce ambiente, dai filtri ottici e dalle caratteristiche intrinseche dei sensori. Questi algoritmi, sviluppati attraverso studi approfonditi di fisica e percezione visiva, permettono di ottenere una resa cromatica naturale e coerente, elemento essenziale per la qualità complessiva dell’immagine.
La complessità degli algoritmi applicati nella fotografia computazionale richiede una solida conoscenza delle tecniche matematiche e l’integrazione di sistemi hardware e software altamente specializzati. L’interazione tra processori grafici dedicati, chip di intelligenza artificiale e architetture di rete consente di eseguire in tempo reale operazioni che una volta richiedevano ore di elaborazione. Tale sinergia ha permesso di implementare tecniche avanzate anche in dispositivi portatili, abbattendo i limiti tra fotografia professionale e applicazioni consumer.
La continua evoluzione degli algoritmi e l’integrazione dei sistemi di intelligenza artificiale hanno cambiato radicalmente la fotografia, rendendo possibile un livello di precisione e di controllo che prima era irraggiungibile. Le innovazioni in questo campo hanno aperto nuove possibilità creative, consentendo ai fotografi di esplorare modalità di espressione visiva che sfruttano la potenza dei dati e della matematica per interpretare la realtà in maniera sempre più sofisticata.
Integrazione operativa della fotografia computazionale nei workflow moderni
Il trasferimento delle tecniche di fotografia computazionale nei workflow operativi moderni ha determinato una profonda trasformazione nei processi di produzione e gestione delle immagini. Nei sistemi fotografici contemporanei, l’adozione di algoritmi avanzati e l’integrazione di processori dedicati hanno permesso di creare flussi di lavoro altamente efficienti, in grado di elaborare e ottimizzare le immagini in maniera quasi automatica. Le apparecchiature moderne catturano dati e intervengono subito, già durante la fase di acquisizione, applicando correzioni in tempo reale che garantiscono un elevato standard qualitativo fin dal momento dello scatto.
La gestione integrata dei dati acquisiti in formato RAW, abbinata a software di post-elaborazione che utilizzano tecniche di machine learning, consente di ottenere immagini di alta qualità senza richiedere un intervento manuale prolungato. I flussi di lavoro moderni prevedono che il dispositivo fotografico esegua in automatico operazioni di riduzione del rumore, bilanciamento del bianco e miglioramento della nitidezza, utilizzando algoritmi che sono stati sviluppati e affinati nel corso degli ultimi anni grazie al contributo di numerosi ricercatori e ingegneri informatici. La presenza di chip dedicati per l’elaborazione dei segnali visivi e la gestione di reti neurali integrate rappresenta un elemento distintivo dei sistemi odierni, che sfruttano la potenza computazionale per garantire immagini di qualità elevata anche in condizioni di scarsa illuminazione o in situazioni dinamiche.
Le interfacce utente dei moderni sistemi di fotografia computazionale offrono al fotografo la possibilità di intervenire sui parametri tecnici con una precisione che supera di gran lunga quella dei sistemi analogici. La personalizzazione del flusso di lavoro, che comprende la possibilità di regolare algoritmi specifici, consente di adattare il trattamento dell’immagine alle caratteristiche della scena e alle preferenze stilistiche dell’operatore. La gestione dei metadati acquisiti durante lo scatto diventa fondamentale per garantire la coerenza del processo, consentendo di archiviare informazioni tecniche dettagliate come l’apertura, il tempo di esposizione, la sensibilità ISO e persino le condizioni ambientali in cui è stata realizzata l’immagine.
L’integrazione di tecnologie AI nei workflow fotografici ha rivoluzionato anche il processo di archiviazione e catalogazione delle immagini. I sistemi di gestione digitale, abbinati a database intelligenti, permettono di indicizzare e catalogare le opere in maniera automatizzata, facilitando la ricerca e l’analisi storica dei contenuti. La capacità di associare a ogni immagine una serie di metadati tecnici e semantici ha aperto la strada a nuove metodologie di conservazione e di studio, in cui il valore dell’immagine va ben oltre il suo aspetto visivo, diventando parte integrante di un patrimonio digitale che può essere consultato e analizzato nel tempo.
Le innovazioni operative nei flussi di lavoro della fotografia computazionale si estendono anche all’ambito della collaborazione e della condivisione dei contenuti. Piattaforme cloud integrate con sistemi di intelligenza artificiale permettono di gestire, elaborare e distribuire immagini in maniera simultanea su più dispositivi e in diverse location, garantendo una continuità operativa che ha rivoluzionato il modo in cui i team fotografici lavorano in ambienti professionali. Le capacità di elaborazione distribuita e di sincronizzazione dei dati assicurano che ogni operazione venga eseguita con una precisione elevata, minimizzando errori e garantendo la massima efficienza.
L’adozione di queste tecnologie richiede una formazione specifica e una conoscenza approfondita delle metodologie digitali, elementi che stanno diventando imprescindibili per i professionisti del settore. Il rapporto tra fotografo e macchina si trasforma in una collaborazione sinergica, in cui l’intelligenza artificiale agisce come un assistente tecnico che ottimizza ogni fase del processo creativo. Questo modello operativo, basato su standard di precisione e su una gestione integrata dei dati, costituisce la base per un nuovo paradigma della produzione fotografica, in cui la qualità dell’immagine è garantita dall’interazione armoniosa tra tecnologia e creatività.
La diffusione della fotografia computazionale ha inciso sul processo di acquisizione e, in misura crescente, sulla distribuzione e sulla fruizione delle immagini. Le piattaforme digitali, in grado di gestire elevati volumi di dati, si interfacciano con sistemi di analisi e visualizzazione che rendono ogni immagine accessibile e verificabile in tempo reale. La sicurezza dei dati e la protezione dei contenuti rappresentano aspetti cruciali in questo contesto, e i sistemi di backup e di archiviazione distribuita giocano un ruolo fondamentale nel garantire l’integrità delle informazioni nel lungo periodo.
Gli smartphone di ottobre 2026
La rassegna dei telefoni più recenti mostra che la rincorsa va ormai oltre i megapixel. Apple ha presentato l’iPhone 18 Pro il 9 settembre 2026, in vendita dal 18 settembre. Il sensore principale Fusion da 48 megapixel adotta un’apertura variabile con sei lamelle, regolabile in automatico oppure in manuale su quattro livelli dall’app Fotocamera, e il chip A20 Pro raddoppia, secondo i dati dichiarati, la potenza dedicata all’intelligenza artificiale rispetto all’A19 Pro. Per l’Italia i listini riportati dalla stampa di settore partono, al 21 ottobre 2026, da 1.489 euro per l’iPhone 18 Pro e da 1.639 euro per il Pro Max. Un’apertura meccanica variabile in un telefono è un ritorno alla fotografia di sempre: il diaframma, che il software aveva simulato per anni con lo sfocato artificiale, torna a essere un pezzo di metallo.
Google ha annunciato la serie Pixel 11 il 13 agosto 2026, con vendite dal 20 agosto. Il chip Tensor G6 promette un’elaborazione AI sul dispositivo fino a 3,5 volte più veloce del Tensor G5, secondo l’azienda. Sul Pixel 11 base il sensore principale da 48 megapixel raccoglie il 56% di luce in più rispetto alla generazione precedente, mentre i modelli Pro offrono un teleobiettivo da 48 megapixel e uno zoom Pro fino a 120x. Night Sight è stata riprogettata e, sempre secondo Google, acquisisce le immagini fino a 4,5 volte più in fretta. Sono dichiarazioni dei produttori: aspettiamo prove indipendenti prima di trasformarle in verdetti.
Samsung ha puntato sul Galaxy S26 Ultra, arrivato nei primi mesi del 2026, con un sensore principale da 200 megapixel dall’apertura vicina a f/1.4, un teleobiettivo da 50 megapixel e una gamma di zoom da 0,6x a 100x. Il motore di elaborazione ProVisual Engine lavora durante l’inquadratura e subito dopo lo scatto, ed è parte del software al punto da non poter essere disattivato; chi vuole meno intervento può scattare in modalità Pro. L’Assistente Foto, che rimuove oggetti e modifica gli scatti con comandi testuali, richiede invece una connessione a internet e un account Samsung.
Il quadro che ne esce è coerente. L’hardware ottico migliora, il calcolo lo accompagna e, sempre più spesso, si spinge a generare contenuto invece di limitarsi a ripulirlo. È il confine su cui conviene tenere gli occhi aperti.
Provenienza e trasparenza: C2PA e AI Act
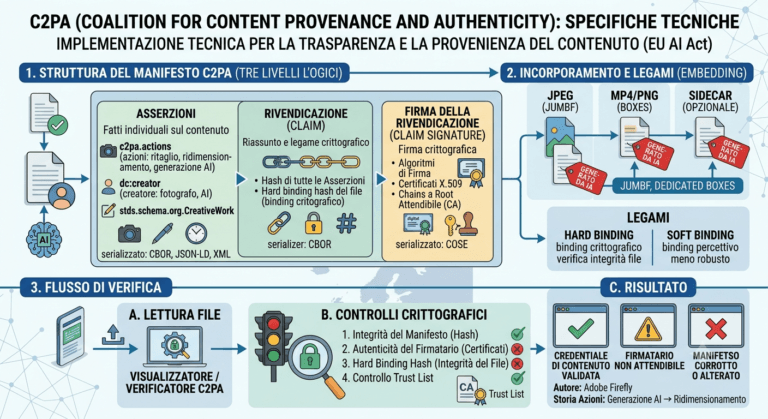
Quando l’immagine è il risultato di tanti passaggi automatici, la domanda «che cosa è stato fatto a questo file?» diventa legittima. La risposta tecnica più diffusa si chiama C2PA, la coalizione che sviluppa le specifiche dei Content Credentials, dati firmati che attestano origine e storia di un contenuto. Con i Pixel 10, presentati il 20 agosto 2025, Google ha integrato le credenziali in ogni foto JPEG scattata con l’app Pixel Camera, e l’app ha ottenuto l’Assurance Level 2, il livello più alto oggi definito dal programma di conformità C2PA. Anche Apple lavora in questa direzione: secondo la stampa italiana, la funzione Apple Reference Image dell’iPhone 18 Pro firma i dati catturati dal sensore e produce un’immagine di riferimento non modificabile, ma al lancio non è disponibile per la cattura nell’Unione europea.
Sul piano normativo, l’articolo 50 dell’AI Act europeo, con gli obblighi di trasparenza sui contenuti generati dall’intelligenza artificiale, si applica dal 2 agosto 2026. I fornitori devono marcare in modo leggibile dalle macchine i contenuti sintetici, e i deepfake destinati al pubblico devono portare un’etichetta visibile. Per i sistemi già sul mercato prima di quella data, il calendario riportato dalla stampa prevede tempo fino al 2 dicembre 2026. Si tratta di un quadro in evoluzione e di una sintesi giornalistica, non di una consulenza legale: chi pubblica professionalmente deve verificare il testo ufficiale.
Per un archivio fotografico o una redazione, il punto pratico è semplice. Conservare il RAW originale, registrare le modifiche e, dove la fotocamera lo consente, mantenere le credenziali di provenienza allegate al file.
Fotografia o calcolo? Un taglio editoriale
La storia della fotografia ci insegna a diffidare delle formule come «finalmente l’immagine è manipolata». L’immagine lo è sempre stata. Nell’Ottocento Gustave Le Gray stampava i suoi paesaggi marini combinando due negativi, uno per il mare e uno per il cielo, perché i materiali sensibili dell’epoca non reggevano entrambi i contrasti in un solo scatto. Un secolo dopo Ansel Adams considerava il negativo come uno spartito e la stampa come la sua esecuzione, e in camera oscura schermava e bruciava le zone dell’immagine per ottenere il risultato voluto. La fusione di più esposizioni di un telefono moderno applica la stessa logica, con una velocità e un’automazione inimmaginabili.
La differenza sta in chi decide. In camera oscura le scelte erano del fotografo, discutibili e firmate. Nel telefono molte scelte appartengono a un modello addestrato su immagini altrui, e il fotografo le eredita senza conoscerle. Un volto levigato, un cielo reso più blu, un dettaglio ricostruito dove il sensore non aveva registrato nulla: sono decisioni estetiche prese a monte. Per il fotoreporter questo apre un problema serio, perché la fiducia nel documento dipende dal sapere che cosa è stato cambiato.
C’è poi il «momento decisivo» di Henri Cartier-Bresson. Un software che fonde una raffica di fotogrammi scattati in una frazione di secondo registra una piccola finestra di tempo, ricomposta in un’unica immagine, più che un istante. Può essere un limite, e può essere un vantaggio. Il fotografo che sceglie il soggetto, la luce e l’inquadratura resta l’autore del gesto principale, e la tecnologia gli concede un margine di errore più ampio. Tocca a lui, però, sapere quando spegnere l’automatismo e tornare al RAW.
Domande frequenti
Qual è la differenza tra fotografia computazionale e post-produzione?
La post-produzione interviene dopo lo scatto, per scelta dell’autore, su un file già formato. La fotografia computazionale entra nel processo prima e durante lo scatto: unisce più fotogrammi, stima la profondità, riconosce i soggetti e produce l’immagine finale senza che l’utente veda i passaggi intermedi. Le due cose si sovrappongono nel flusso di lavoro, ma la prima è una scelta dell’operatore, la seconda un automatismo del dispositivo.
L’HDR dei telefoni usa il bracketing?
Non sempre. Il bracketing classico fonde esposizioni diverse della stessa scena. Il sistema HDR+ di Google, descritto nel 2016 da Hasinoff e colleghi, scatta invece una raffica di fotogrammi tutti sottoesposti, li allinea e li fonde partendo dai dati raw, perché sommare molti scatti scuri riduce il rumore senza bruciare le alte luci.
Posso disattivare l’elaborazione automatica?
Dipende dal modello. Sul Galaxy S26 Ultra, per esempio, il motore ProVisual non si disattiva, ma la modalità Pro riduce l’intervento automatico. Sui telefoni più recenti, scattare in formato RAW è il modo più pratico per conservare un file con elaborazione minima, anche se alcune ottimizzazioni restano incorporate nei dati.
Come si riconosce una foto elaborata o generata dall’intelligenza artificiale?
A occhio, spesso, non si riconosce. Per questo si sviluppano standard come C2PA, che allegano al file credenziali firmate su origine e modifiche. Funzionano però solo se chi scatta e chi pubblica le conserva, e la loro assenza non prova di per sé che un’immagine sia falsa.
Una foto computazionale è ancora una fotografia?
Sì, finché parte dalla luce registrata da un sensore davanti a una scena reale. Il discorso cambia quando il software aggiunge contenuto che in quella scena non c’era: in quel caso conviene dichiararlo, soprattutto in ambito giornalistico.
Per altri approfondimenti d’autore si veda la raccolta Gli editoriali.
Fonti
- Hasinoff et al., Burst photography for high dynamic range and low-light imaging on mobile cameras, SIGGRAPH Asia 2016
- Google Research, See Better and Further with Super Res Zoom on the Pixel 3
- Google, Pixel and Android and C2PA Content Credentials
- C2PA, specifiche tecniche dei Content Credentials
- Tom’s Hardware Italia, AI Act e obblighi di trasparenza sui contenuti
- SmartWorld, iPhone 18 Pro ufficiali
- Multiplayer.it, Samsung Galaxy S26 Ultra provato
- Business Today, Google Pixel 11 series
Aggiornato Ottobre 2026