Il primo febbraio 2026, nel primo pomeriggio, la Polizia di Stato pubblicò sul proprio account Facebook la fotografia di un agente che soccorre un collega caduto durante gli scontri di Torino del giorno prima. L’immagine fece il giro dei giornali. Il fotoreporter Michele Lapini segnalò per primo che conteneva elementi generati dall’intelligenza artificiale, e Il Post ricostruì la vicenda: un’immagine modificata con l’IA, con ogni probabilità a partire da un fotogramma tratto da un video reale, fino a cambiare volti e sfondo. L’episodio era vero, la fotografia che lo raccontava molto meno.
«Questa immagine è vera?» è la domanda che accompagna il fotogiornalismo fin dall’Ottocento, e nel 2026 ha un peso nuovo. Chi falsificava una fotografia nel Novecento aveva bisogno di un laboratorio, di tempo e spesso di un apparato di Stato. Oggi bastano un modello generativo e pochi secondi. Cambiano la scala e la velocità, resta la vecchia tentazione di far dire alle immagini ciò che conviene.
Questa guida segue due fili. Il primo è storico: dalle fotografie ritoccate sotto Stalin al dibattito sul fotoritocco nelle redazioni, passando per il miliziano di Robert Capa, per capire che cosa le redazioni sapevano già. Il secondo è pratico: che cosa si può verificare oggi, con quali strumenti e con quali limiti, e che cosa dicono la legge italiana e il regolamento europeo.
In Sintesi
- La manipolazione delle fotografie di notizia precede il digitale di quasi un secolo: ritocchi sovietici, fotomontaggi, dubbi sulle immagini di guerra.
- Il caso di Torino (febbraio 2026) mostra la forma più insidiosa di falso: una scena reale rielaborata con l’IA, senza un’immagine inventata da zero.
- I rilevatori automatici restituiscono probabilità e sbagliano in entrambe le direzioni: la Columbia Journalism Review li considera un indizio, mai un verdetto.
- I Content Credentials C2PA documentano la catena di custodia di un file dallo scatto in poi, ma non certificano che ciò che si vede sia accaduto, e molte piattaforme ne cancellano i dati.
- In Italia l’articolo 612-quater del Codice penale punisce la diffusione illecita di contenuti falsificati con l’IA, mentre l’articolo 50 dell’AI Act impone obblighi di trasparenza dal 2 agosto 2026.
- Il metodo che regge nel tempo mette in fila provenienza, ricerca inversa, metadati, esame visivo e contesto, e tiene sempre aperta la possibilità di non pubblicare.
Forbici, colla e pennelli: la falsificazione prima del pixel
La fotografia nacque con la fama di testimone imparziale, e nel giro di pochi decenni chi ne sfruttava la credibilità imparò a piegarla. Già nell’Ottocento il ritoccatore interveniva a mano sul negativo, e i giornali illustrati fecero presto del ritocco una routine. Fu il Novecento dei regimi, però, a trasformare l’intervento sull’immagine in una politica di Stato.
Nell’Unione Sovietica la correzione del passato visivo seguiva le sorti dei dirigenti. David King ne raccolse gli esempi nel libro The Commissar Vanishes: nelle versioni ritoccate della fotografia in cui Lenin parla alla folla scompaiono Trotskij e Kamenev, e Nikolaj Ezhov, ritratto a passeggio con Stalin lungo il canale Mosca-Volga, diventa un tratto d’acqua dopo l’arresto del 1939. Nessuna nota avvertiva il lettore. Chi cadeva in disgrazia usciva dalla storia e dalle fotografie insieme.
In Germania Heinrich Hoffmann (1885-1957), fotografo ufficiale di Hitler, deteneva di fatto il monopolio delle immagini del Führer e ne governava la presenza pubblica con scelte di inquadratura, ritocchi e una selezione severa degli scatti da distribuire. Anche in Italia la propaganda del Ventennio costruì il proprio repertorio visivo, come racconta l’articolo su fotografia fascista e propaganda.
Il fotomontaggio, nato nel clima del dadaismo, mostra l’altra faccia della questione. John Heartfield (1891-1968), nato Helmut Herzfeld, pubblicò tra il 1930 e il 1938 sulla rivista Arbeiter-Illustrierte-Zeitung una serie di montaggi contro il nazismo. Erano satira dichiarata: il lettore sapeva di guardare una costruzione. I ritoccatori sovietici lavoravano al contrario, e il loro lavoro riusciva solo se nessuno se ne accorgeva. La differenza sta tutta nel patto con chi guarda.
Ciò che un ritoccatore sovietico otteneva in giorni, con lamette, inchiostro e rifotografie, oggi un sistema di intelligenza artificiale lo produce in pochi secondi, senza competenze particolari e a costo quasi nullo. La falsificazione visiva è antica. Il suo prezzo, per la prima volta, è crollato. Su questo punto il tema si lega a ciò che si discute nella relazione tra fotografia e intelligenza artificiale.
Il miliziano di Capa e il dubbio che non si chiude
Robert Capa (1913-1954), nome d’arte di Endre Friedmann, nato a Budapest e morto per una mina in Indocina, firmò con Morte di un miliziano l’immagine più discussa della fotografia di guerra. Un repubblicano in camicia chiara, colto nell’istante in cui sembra cadere all’indietro, il fucile che scivola dalla mano. La rivista francese Vu la pubblicò il 23 settembre 1936, Life la ripropose il 12 luglio 1937. Il luogo tradizionale dello scatto è Cerro Muriano, sul fronte di Cordova.
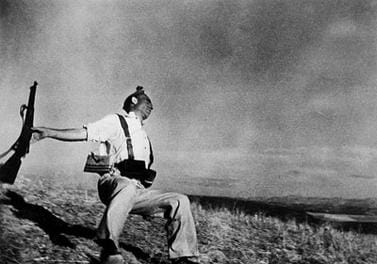
I sospetti arrivarono tardi. Nel 1975 Phillip Knightley, in The First Casualty, riferì la testimonianza del giornalista O. D. Gallagher, secondo cui Capa gli avrebbe confidato di aver fotografato una scena messa in piedi. I difensori del fotografo risposero che non esiste prova di un incontro tra i due prima del 1939, e che il racconto non reggeva la cronologia. Nel 1996 una ricerca negli archivi militari indicò come soggetto Federico Borrell García, un operaio di ventiquattro anni caduto proprio in quei giorni a Cerro Muriano. Nel 2002 Richard Whelan, biografo di Capa, scrisse un articolo per sostenere l’autenticità dello scatto.
La discussione non si fermò lì. Il ricercatore José Manuel Susperregui sostenne nel libro Sombras de la Fotografía (2009) che la fotografia fu scattata a Espejo, a circa cinquanta chilometri da Cerro Muriano, riconoscendo nello sfondo le linee dei monti locali. Il quotidiano El Periódico de Catalunya mandò inviati sul posto e riferì una somiglianza evidente tra il paesaggio attuale e quello delle immagini di Capa. La «valigia messicana» dei negativi di Capa, Gerda Taro e David Seymour, giunta all’International Center of Photography nel 2007, includeva fotogrammi dello stesso luogo e dello stesso periodo, che collocano l’azione vicino a Espejo, ma non il negativo del miliziano.
Gli studiosi restano divisi sul significato dell’evento: il soldato fu colpito in combattimento, la scena venne recitata durante un’esercitazione, oppure un colpo partì mentre posava? Lo stato delle ricerche non consente di dirlo con certezza, e ogni ricostruzione che si presenti come definitiva va letta con cautela. Chi vuole seguire il dibattito nei dettagli trova materiale nell’articolo sulla composizione dell’immagine.
Per la verifica contemporanea questo caso insegna una lezione precisa. Un’immagine si autentica con un fascicolo: negativi, sequenze di scatti, luoghi, date, testimoni, pubblicazioni. Il verdetto unico non esiste. Capa aveva alle spalle Vu, Life e in seguito Magnum, e questo bastò a farlo credere per decenni. Nel 2026 la fiducia istituzionale da sola non basta più, perché chiunque può imitarne l’aspetto.
Vietnam: due fotografie vere e il loro peso
Nella guerra del Vietnam i fotoreporter accreditati seguivano le truppe con restrizioni molto minori di quelle imposte nei conflitti successivi, e le immagini che ne uscirono pesarono sull’opinione pubblica americana. Due di esse servono a capire che cosa significhi dire «vera» di una fotografia.
L’8 giugno 1972, a Trảng Bàng, un aereo sudvietnamita sganciò per errore napalm su civili e soldati. Nick Ut (nato Huỳnh Công Út, 1951), fotografo dell’Associated Press, è stato per mezzo secolo l’autore riconosciuto della fotografia di Kim Phúc, allora una bambina di nove anni che corre nuda lungo la strada. L’immagine vinse il Pulitzer nel 1973. Nel 2025 il documentario The Stringer ha attribuito lo scatto a un altro autore, il collaboratore vietnamita Nguyễn Thành Nghệ. L’Associated Press ha concluso che è possibile che l’abbia scattata Ut e ha mantenuto il suo nome nei crediti, mentre il World Press Photo, dopo una propria indagine, ha sospeso l’attribuzione. Ut contesta la ricostruzione. Qui l’autenticità riguarda la paternità: la scena è accaduta, ma resta aperto chi ne fu l’autore.
Il 1° febbraio 1968, a Saigon, durante l’offensiva del Tet, Eddie Adams (1933-2004) fotografò il generale Nguyễn Ngọc Loan nell’atto di sparare a un prigioniero vietcong, Nguyễn Văn Lém. La fotografia gli valse il Pulitzer del 1969. Trent’anni dopo, quando Loan morì, Adams scrisse per Time un ricordo in cui diceva, in sostanza, che il generale aveva ucciso il vietcong e lui aveva ucciso il generale con la sua macchina fotografica. Aggiungeva che le fotografie possono mentire anche senza essere manipolate, perché sono mezze verità.
Quella frase vale più di molti manuali. Un fotogramma vero è sempre un taglio, una frazione di secondo senza il prima e il dopo. Nessuna tecnologia di verifica garantisce che ciò che l’inquadratura esclude non cambierebbe il senso della scena. Per questo la didascalia, il contesto e la firma di chi era presente pesano quanto i pixel, e per questo un falso generato da zero si muove su un terreno diverso, perché non ha mai avuto un luogo e un momento dietro di sé.
Vale per la fotografia di guerra in generale: la sua forza viene dall’esserci stati. Un sistema di verifica serio cerca prima di tutto la traccia di quella presenza.
Photoshop in redazione: Hansen, Contreras, McCurry
Photoshop uscì nel 1990 e in pochi anni cambiò il lavoro delle redazioni. Tolse alla correzione la camera oscura, la lentezza e le tracce fisiche. Le agenzie passarono ai flussi digitali negli anni Novanta, e con loro arrivarono regole scritte su ciò che un fotografo può e non può fare a un file.
Il primo grande dibattito pubblico fu quello su Paul Hansen, svedese di Dagens Nyheter, il cui scatto «Gaza Burial», realizzato il 20 novembre 2012, mostra uomini che portano due bambini morti verso la moschea. Il 15 febbraio 2013 vinse il World Press Photo of the Year e subito partirono le accuse di composizione e di ritocco eccessivo. Il World Press Photo incaricò analisti indipendenti e il 14 maggio 2013 comunicò gli esiti. Hany Farid e Kevin Connor trovarono ritocchi di colore e di tono, senza composizioni né spostamenti di elementi. L’olandese Eduard de Kam rilevò un forte lavoro di post-produzione, ma anche che i pixel del file raw e quelli del JPEG inviato al concorso occupavano le stesse posizioni. Il premio rimase a Hansen.
Il secondo caso viene dopo, e la cronologia conta: nel gennaio 2014 l’Associated Press licenziò Narciso Contreras, che aveva condiviso un Pulitzer nel 2013 con i colleghi dell’agenzia per la copertura della guerra in Siria. Contreras aveva cancellato con Photoshop una telecamera dall’angolo di una fotografia scattata in Siria. L’agenzia riesaminò quasi cinquecento suoi scatti e non trovò altre alterazioni. Lui dichiarò di aver commesso un errore terribile e di assumersene la responsabilità. L’intervento era minimo, ma la regola dell’agenzia non ammette aggiunte né rimozioni, e fu applicata.
Nel 2015 il World Press Photo, secondo quanto riportò Internazionale, respinse circa il venti per cento delle immagini inviate, tre volte più dell’anno precedente, per eccesso di ritocco. Da allora i partecipanti devono consegnare i file originali, e le regole ammettono correzioni di tono, schiariture e bruciature, conversione in bianco e nero, mentre vietano di togliere elementi, salvo i difetti dovuti al sensore come la polvere. Il file raw è diventato il negativo digitale, cioè il documento da esibire a richiesta.
Nel maggio 2016 il fotografo Paolo Viglione, sul proprio blog, segnalò un errore in una stampa di Steve McCurry esposta alla Venaria Reale di Torino: in una veduta di Cuba un palo della segnaletica risultava privo della parte inferiore, fuso con un passante. Altre immagini in mostra presentavano rimozioni di persone. McCurry si scusò, attribuì i ritocchi a un collaboratore che avrebbe agito di propria iniziativa e disse che il tecnico era stato allontanato. Sull’episodio Il Post riportò che Magnum non prese alcuna posizione ufficiale. Il caso aprì la discussione sul confine tra reportage e fotografia d’autore, e mostrò che l’etica del ritocco riguarda anche chi stampa e prepara le mostre.
Questi episodi segnano un punto di metodo: in tutti c’era un originale da confrontare. Il raw di Hansen, il file di Contreras, la stampa di McCurry accanto allo scatto. La manipolazione digitale tradizionale lascia sempre una traccia reale sulla quale intervenire. L’intelligenza artificiale generativa può fare a meno anche di quella.
Dalle reti avversarie ai modelli di diffusione
La parola deepfake è giovane. Comparve alla fine del 2017, quando su Reddit un utente che si faceva chiamare così cominciò a pubblicare video in cui i volti di persone note erano stati sostituiti con tecniche di apprendimento profondo. Il termine unisce deep learning e fake. La tecnica aveva però una storia più lunga.
Nel 2014 Ian Goodfellow e i suoi coautori presentarono alla conferenza NIPS, oggi NeurIPS, le reti generative avversarie, in sigla GAN. Due reti vengono addestrate in competizione: una produce immagini false sempre più credibili, l’altra impara a distinguerle da quelle vere, e il miglioramento reciproco affina il generatore. Nel giro di pochi anni i programmi di scambio di volti diventarono accessibili a chiunque, con tutte le conseguenze note.
Nel 2022 i modelli di diffusione, tra cui Stable Diffusion, portarono la qualità a un livello nuovo: si parte da rumore casuale e lo si «ripulisce» passo dopo passo seguendo una descrizione testuale, fino a ottenere un’immagine che nessuna macchina fotografica ha mai visto. Da allora ogni nuova versione ha corretto i difetti di quella precedente, e le guide che elencano le anomalie tipiche invecchiano nel giro di qualche mese. Chi lavora in una redazione ha davanti un bersaglio mobile.
Torino, primo febbraio 2026: anatomia di una foto ritoccata
Il 31 gennaio 2026 a Torino un corteo contro lo sgombero del centro sociale Askatasuna degenerò in scontri con la polizia. Un video girato sul posto, ripreso dal sito Torino Oggi, mostra un agente isolato che viene aggredito e un collega che lo soccorre trascinandolo via. Da quel video fu estratto un fotogramma, e il fotogramma cominciò a circolare.
La ricostruzione de Il Post, pubblicata il 5 febbraio, segue le versioni una dopo l’altra. La sera del 31 gennaio alcuni utenti condividono copie più nitide, con il volto di uno dei due agenti cancellato. Il mattino dopo un sindacato dei carabinieri rilancia una variante con il volto visibile. Poco più tardi la Polizia Penitenziaria la ripubblica ritagliata e con un’ombra, taggando la Polizia di Stato, che nel pomeriggio del primo febbraio mette online la versione più ampia e senza scudo. Ogni passaggio, insomma, allontanava un po’ l’immagine dal video.
Le anomalie elencate sono quelle tipiche di un software che «ricostruisce» ciò che non vede. Sul casco dell’agente in piedi la scritta «polizia» è sostituita da segni illeggibili. Sulla giacca dell’agente in ginocchio una lettera ha un taglio che non dovrebbe esserci. Il soccorritore non porta la maschera antigas che invece indossa nel video, il suo volto ha i baffi mentre l’agente reale ha la barba, i capelli del ferito sono più lunghi. Lo sfondo non corrisponde al luogo ripreso: mancano un’auto bianca e un muretto, la ringhiera si interrompe, la pavimentazione cambia. Il sistema Hive Moderation attribuì all’immagine una probabilità del 99 per cento di essere generata dall’IA, e Open riferì di una verifica con lo strumento SynthID di Google segnalata da Lapini il 4 febbraio. Facebook e Instagram applicarono un avviso sulla possibile alterazione. Il Post presenta la modifica con l’IA come stabilita dalle anomalie e dal risultato di Hive, e come probabile soltanto l’uso del fotogramma del video come base. Resta da stabilire con quale software sia avvenuta la modifica.
Questo caso smentisce una convinzione diffusa, cioè che il falso arrivi da fonti sospette. Qui è arrivato da un canale istituzionale, a partire da un fatto vero, con l’intento verosimile di rendere più nitida e drammatica una scena. Nessun complotto, probabilmente: un ritocco fatto in buona fede, o per fretta, con strumenti che inventano dettagli. L’effetto sul lettore è lo stesso. Chi guarda vede volti e scritte precisi dove la fonte ne offriva di confusi, e non ha modo di sapere quali siano ricostruiti.
Anche per un lettore comune la lezione è semplice: quando il video originale esiste, il confronto fotogramma contro fotogramma smaschera quasi tutto. A Torino a segnalare per primo le incongruenze è stato un fotoreporter, Michele Lapini. La verifica nasce dalla pazienza di guardare due volte. Sul versante politico, la stessa logica si ritrova nel caso delle immagini false di Giorgia Meloni.
Tre famiglie di falsi e le loro tracce
Parlare di «deepfake» al singolare confonde. Dal punto di vista di chi verifica esistono almeno tre famiglie di falsi, ciascuna con tracce proprie, e distinguerle orienta il controllo.
La prima è lo scambio di volto, soprattutto nei video. Un modello apprende il viso di una persona da molte immagini e lo applica al corpo di un’altra, seguendo espressioni e movimenti. Le tracce stanno ai bordi del volto, nei riflessi degli occhi, nel sincronismo tra labbra e voce, nei denti che cambiano forma da un fotogramma all’altro. Sono segni che una ripresa di qualità e un buon montaggio possono nascondere.
La seconda famiglia comprende le immagini interamente generate. Non c’è un originale, non c’è un luogo: il modello assembla pattern appresi da milioni di immagini. Le anomalie classiche sono mani con troppe dita, testi illeggibili, simmetrie eccessive, texture che si ripetono, sfondi incoerenti, ombre che puntano in direzioni diverse. Sono indizi utili ma instabili, perché ogni nuova versione dei modelli li attenua. Un falso privo di difetti visibili può comunque tradirsi per mancanza di contesto: nessun fotografo, nessuna sequenza, nessun testimone, nessuna prima apparizione verificabile.
La terza famiglia è quella delle immagini ibride, ed è la più insidiosa per il fotogiornalismo. Una fotografia reale viene modificata solo in parte, con tecniche di inpainting, che riempiono un’area con contenuto generato, oppure con la sostituzione di un volto. Il caso di Torino rientra qui. I rilevatori addestrati a distinguere il reale dal sintetico tendono a faticare con i ritocchi parziali, perché il resto del file è autentico e mantiene le caratteristiche di un sensore vero. È la versione algoritmica di ciò che si faceva con le forbici negli anni Trenta: un intervento mirato che lascia intatto il contorno.
I rilevatori automatici e i loro limiti
Esiste ormai un mercato di strumenti che dichiarano di riconoscere i contenuti sintetici. Gli esempi citati dal Tow Center della Columbia Journalism Review in una guida non tecnica per giornalisti, pubblicata a marzo 2025 da Kaylee Williams, comprendono Deepware Scanner, DeepFake-o-Meter, Optic, Hive Moderation, V7 e Invid. Il giudizio di fondo è netto: l’autrice scrive che questi strumenti non possono essere considerati affidabili per intercettare contenuti generati o manipolati dall’IA, e che la fede cieca nei rilevatori indebolisce il rigore giornalistico.
Le ragioni sono strutturali. I rilevatori falliscono spesso davanti a tecniche assenti dai dati di addestramento, e chi produce falsi può levigare le texture, correggere la luce e togliere le anomalie per eludere i controlli. Il risultato è una probabilità, per esempio «70 per cento umano», che non dice quali parti del file siano state alterate né se il contenuto sia accurato. Un’etichetta parziale di «artificiale» induce a pensare che l’intera immagine sia falsa. Si sbaglia in entrambe le direzioni: un falso può passare per autentico, e una fotografia genuina può essere scartata per un punteggio sfavorevole.
Il CJR cita anche un esperimento dell’Università del Mississippi del 2024, secondo cui i giornalisti tendevano ad appoggiarsi ai risultati degli strumenti quando coincidevano con la loro intuizione, o quando gli altri controlli non portavano a nulla. Risultati contrastanti, d’altra parte, aumentavano la confusione. L’indicazione pratica è di trattare ogni verdetto come un elemento tra gli altri e di diffidare soprattutto di quello che conferma ciò che si pensava già.
A Torino i rilevatori hanno indicato nella direzione giusta, e il dato è stato utile. A segnalare il problema era stato però per primo un fotoreporter, a conferma che l’ordine delle operazioni ha il suo peso: prima la provenienza e il confronto con le fonti, poi, se serve, lo strumento.
Content Credentials: la catena di custodia dell’immagine
La risposta più strutturata al problema lascia da parte il pixel e guarda alla storia del file. La Content Authenticity Initiative fu lanciata il 4 novembre 2019 da Adobe, New York Times e Twitter. Il 22 febbraio 2021 nacque la C2PA, la Coalition for Content Provenance and Authenticity, con sei membri fondatori: Adobe, Arm, BBC, Intel, Microsoft e Truepic. Lo standard, rilasciato con licenza libera da royalty, è arrivato nell’aprile 2026 alla versione 2.4. I Content Credentials sono la sua applicazione per il pubblico: un manifesto firmato crittograficamente che accompagna il file e registra chi l’ha creato, con quale dispositivo, quali modifiche sono state applicate e se è intervenuta l’IA.
Il fotografo Glyn Dewis, in un articolo del 27 febbraio 2026, usa un’immagine efficace: un’etichetta nutrizionale per le fotografie. Il sistema funziona in quattro tappe. All’acquisizione la fotocamera firma il file, in fase di modifica programmi come Photoshop e Lightroom registrano gli interventi, all’esportazione l’autore sceglie che cosa includere, e infine chiunque può verificare il tutto, ad esempio con lo strumento contentcredentials.org/verify. Se pixel o storia vengono alterati dopo la firma, il controllo crittografico fallisce.
L’hardware si sta muovendo. La Leica M11-P, presentata nell’ottobre 2023, è accreditata come la prima fotocamera di serie con Content Credentials integrati, con la chiave privata custodita in un chip di sicurezza. Sony ha annunciato nel giugno 2025 il sistema Camera Verify, inizialmente limitato a immagini fisse, modelli di fascia alta e agenzie selezionate. Nell’agosto 2025 Nikon ha aggiunto la funzione alla Z6III con un aggiornamento del firmware, e Google ha inserito i Content Credentials nella fotocamera dei Pixel 10. Su questo versante il sito ha pubblicato un articolo dedicato alle fotocamere C2PA nel 2026.
La storia del Nikon è istruttiva: una vulnerabilità permetteva di combinare immagini non autentiche con fotografie autentiche mantenendo una firma valida, e Nikon ha revocato i certificati interessati. Nessuna catena di fiducia è più robusta del suo anello più debole, ed è sana abitudine pretendere trasparenza su come i produttori gestiscono le chiavi.
I limiti, ben elencati da Dewis, sono di adozione e di uso. Molte piattaforme sociali eliminano i dati incorporati al momento del caricamento, e Facebook è citato come esempio. Lightroom Classic applica le credenziali solo all’esportazione in JPEG e richiede una connessione a internet. Alcune implementazioni sugli smartphone aggiungono la firma soltanto alle immagini elaborate con l’IA, senza toccare gli scatti ordinari. Al CES 2026 diversi visitatori hanno scambiato l’icona per il segno di un contenuto generato, mentre significa il contrario. Le informazioni su identità e modifiche sono facoltative, quindi ogni fotografo decide che cosa mostrare.
C’è poi un limite concettuale, che l’articolo su C2PA e autenticità fotografica sviluppa a fondo: una firma attesta l’integrità della catena, e nulla dice sulla corrispondenza tra l’immagine e il fatto. Una scena allestita davanti a una fotocamera certificata resta una scena allestita, con una firma perfetta. Il vecchio dubbio su Capa sopravvive, con un certificato in più.
Un file senza credenziali può essere autentico lo stesso. Quasi tutta la fotografia di cronaca prodotta prima dello standard, e una parte consistente di quella di oggi, ne è priva. L’assenza è un’informazione da leggere insieme al resto.
Che cosa prevedono la legge 132/2025 e l’AI Act
Il legislatore italiano è intervenuto con la legge 23 settembre 2025, n. 132, in vigore dal 10 ottobre 2025, che contiene disposizioni e deleghe in materia di intelligenza artificiale. All’articolo 26 introduce nel Codice penale l’articolo 612-quater, dedicato all’illecita diffusione di contenuti generati o alterati con sistemi di intelligenza artificiale. Punisce con la reclusione da uno a cinque anni chi cagiona un danno ingiusto a una persona diffondendo, senza il suo consenso, immagini, video o voci falsificati o alterati con l’IA e idonei a indurre in inganno sulla loro genuinità. Di regola si procede a querela della persona offesa, d’ufficio nei casi di particolare gravità, ad esempio se il fatto è connesso a un altro delitto procedibile d’ufficio, se la vittima è incapace o se è coinvolta un’autorità pubblica.
La norma ha una finalità precisa: tutela una persona danneggiata da un contenuto falso che la riguarda. Per le redazioni resta quindi un presidio parziale, che interviene dopo il danno. Il tema delle prove in giudizio, a monte, è trattato nell’articolo sulle fotografie come prove legali.
Sul fronte europeo il Regolamento (UE) 2024/1689, l’AI Act, definisce il deepfake all’articolo 3 come un contenuto immagine, audio o video generato o manipolato dall’IA che assomiglia a persone, oggetti, luoghi, entità o eventi esistenti e che apparirebbe falsamente autentico o veritiero. L’articolo 50 impone obblighi di trasparenza: i fornitori di sistemi generativi devono marcare i contenuti sintetici con segni leggibili da una macchina, mentre chi impiega un sistema per produrre deepfake, o testi su temi di interesse pubblico, deve dichiararlo. Secondo l’analisi di Baker Botts, questi obblighi si applicano dal 2 agosto 2026, con un periodo di tolleranza fino al 2 dicembre 2026 per la marcatura nei sistemi già sul mercato, e l’obbligo di dichiarazione non vale quando il contenuto ha subito una revisione editoriale umana e una persona se ne assume la responsabilità. Il 31 luglio 2026 l’Ufficio europeo per l’IA ha pubblicato un codice di buone pratiche volontario sulla trasparenza dei contenuti generati.
Quest’ultima eccezione interessa direttamente chi lavora in redazione, perché lega l’esenzione a una responsabilità editoriale concreta: qualcuno che guarda, verifica e firma. Chi desidera il quadro di dettaglio trova nell’articolo sull’articolo 50 dell’AI Act gli aspetti tecnici di marcatura e filigrana. Le norme sono utili, ma arrivano comunque a cose fatte, e nessuna sostituisce il controllo prima della pubblicazione.
Il metodo di una redazione, passo per passo
Una redazione che riceve un’immagine in un momento caldo ha poco tempo e molte pressioni. Funziona bene un percorso fisso, applicato sempre nello stesso ordine, perché l’urgenza spinge a saltare i passaggi più noiosi.
Il primo passo riguarda la provenienza. Chi ha scattato, e come è arrivata la fotografia? Un autore identificabile, raggiungibile al telefono, capace di descrivere luogo, ora e inquadrature vicine pesa più di qualsiasi analisi. Si chiede la sequenza completa degli scatti, non il solo fotogramma, e se possibile il file originale. Una fotografia vera ha un prima e un dopo: i fotogrammi vicini, un’altra angolazione, un collega presente. Un file privo di vicini è un campanello d’allarme.
Il secondo passo è la ricerca inversa per immagini, con Google Immagini e Lens, TinEye o Yandex. Molte campagne di disinformazione non usano falsi veri e propri: riciclano una fotografia autentica di altri tempi presentandola come attuale. Scoprire che quell’immagine circolava già anni fa chiude la questione in pochi minuti. Tra gli strumenti dei verificatori c’è anche il plugin InVID, che estrae fotogrammi da un video per sottoporli alla stessa ricerca.
Il terzo passo riguarda i metadati. I dati EXIF raccontano macchina, data, impostazioni e a volte posizione. Mancano di frequente, perché le piattaforme li rimuovono, e possono essere falsificati con facilità. La loro presenza coerente è un indizio, la loro assenza invita a cercare altrove, la loro incoerenza (una data anteriore al lancio della fotocamera indicata, un formato che quel modello non produce) allarma. Se esistono Content Credentials, si controllano con gli strumenti di verifica.
Il quarto passo è l’esame dell’immagine. Si ingrandisce, si guardano mani, testi, bordi dei volti, riflessi negli occhi, coerenza delle ombre, rumore, ripetizioni. È un esame che richiede occhio allenato, e dà risultati in negativo più che in positivo: trovare un difetto aiuta, non trovarne non prova nulla. A Torino il confronto tra la scritta sul casco e il video bastava a insospettire.
Il quinto passo è il contesto. Si geolocalizza la scena con mappe e immagini satellitari, riconoscendo edifici, insegne, profili dei monti. Si controlla l’ora con la posizione del sole e la lunghezza delle ombre, ad esempio con strumenti come SunCalc. Si cerca una seconda fonte indipendente, un testimone, una ripresa diversa dello stesso evento. Quando il contesto non regge, il resto conta poco.
Resta la decisione finale, e va tenuta aperta. Se i controlli non bastano, la risposta onesta è spesso rinunciare a pubblicare, oppure pubblicare con una dicitura che dichiari che cosa è noto e che cosa no. Un ritardo di un’ora costa meno di una rettifica. Gli strumenti di rilevamento, come visto, entrano soltanto come un elemento del fascicolo, mai come sentenza.
Buone pratiche per chi fotografa e per chi pubblica
Chi fotografa per mestiere può proteggere il proprio lavoro con alcune abitudini semplici. Conservare i file raw originali e le sequenze complete degli scatti, perché sono la prima prova di un’immagine autentica, come insegnò il caso Hansen. Registrare le modifiche con un software che le documenti. Se la fotocamera lo permette, attivare la firma C2PA alla ripresa, sapendo che documenta il percorso del file e non la verità della scena. Scrivere didascalie complete, con luogo, ora e circostanze, perché una didascalia accurata è già una forma di provenienza. Con agenzie, riviste e concorsi la prassi più sicura è consegnare insieme al file finale anche l’originale, dichiarando con precisione ciò che è stato fatto, comprese le correzioni di tono. Il caso Contreras mostra quanto sia severa l’applicazione delle regole.
Per chi pubblica, il primo presidio è interno: stabilire prima del caso difficile chi ha l’autorità di verificare, con quali strumenti e in quanto tempo. Il secondo riguarda gli account istituzionali, il cui carattere ufficiale non esime dal controllo, come Torino ha mostrato. Il terzo è la trasparenza verso il lettore. Un’immagine rielaborata, anche solo ripulita con un software, va dichiarata tale, e un’immagine sintetica va etichettata come sintetica. Le fotografie di illustrazione di questa pagina, per esempio, sono immagini stock con i crediti indicati e non pretendono di documentare nulla.
Per ultimi vengono i lettori, che sono la parte meno attrezzata della catena. Una cultura minima della verifica, fatta di tre domande prima di condividere (chi ha scattato, quando è comparsa la prima volta, chi altro la conferma), fa più di molti strumenti. Il sito ha dedicato altri contributi al tema: il problema dell’intelligenza artificiale e delle immagini fotografiche espone gli aspetti giuridici e culturali che qui si possono solo toccare.
Domande frequenti
Come si riconosce una foto generata dall’intelligenza artificiale?
Nessun segno basta da solo. Si cercano anomalie visive (mani, testi, riflessi, ombre), si fa la ricerca inversa, si controllano i metadati e le eventuali credenziali C2PA, si chiede la sequenza completa degli scatti e si verifica il contesto. Un rilevatore automatico può aiutare, ma restituisce una probabilità e va trattato come un indizio.
I rilevatori di deepfake sono affidabili?
Fino a un certo punto. Secondo la guida del Tow Center della Columbia Journalism Review, gli strumenti falliscono quando incontrano tecniche assenti dai loro dati di addestramento, producono errori in entrambe le direzioni e restituiscono punteggi difficili da interpretare. Servono come primo orientamento, dentro un processo di verifica più ampio.
Che cosa sono i Content Credentials e a che cosa servono?
Sono metadati firmati secondo lo standard C2PA che documentano origine e modifiche di un file: dispositivo, autore, software usati, eventuale intervento dell’IA. Servono a ricostruire la catena di custodia di un’immagine, senza stabilire che la scena sia accaduta. Molte piattaforme li eliminano al caricamento, e la loro assenza non indica un falso.
Che reato commette chi diffonde un deepfake in Italia?
L’articolo 612-quater del Codice penale, introdotto dalla legge 132/2025, punisce con la reclusione da uno a cinque anni chi cagiona un danno ingiusto a una persona diffondendo, senza il suo consenso, contenuti falsificati con l’IA e idonei a ingannare. Di regola si procede a querela. Per le situazioni concrete conviene rivolgersi a un avvocato.
Nel caso di Torino la foto era interamente falsa?
Secondo Il Post no: l’immagine è stata modificata con l’IA partendo, con ogni probabilità, da un fotogramma di un video reale degli scontri del 31 gennaio 2026, e ne ha alterato volti, dettagli e sfondo. Il fatto ripreso era accaduto, mentre l’immagine diffusa dalla Polizia di Stato il primo febbraio mostrava particolari che nel video non ci sono.
Altri approfondimenti d’autore si trovano in Gli editoriali.
Fonti
- Il Post, 5 febbraio 2026: la foto della polizia sugli scontri di Torino elaborata con l’intelligenza artificiale
- Columbia Journalism Review, Tow Center: What journalists should know about deepfake detection in 2025
- Glyn Dewis: Content Credentials, la guida per fotografi (27 febbraio 2026)
- Wikipedia: Content Credentials, standard C2PA e implementazioni
- Studio Cataldi: il nuovo reato di deepfake, articolo 612-quater del Codice penale
- Baker Botts: EU AI Act, entrano in vigore gli obblighi di trasparenza dell’articolo 50
- Wikipedia: The Falling Soldier, il miliziano di Robert Capa
- Internazionale: perché il World Press Photo ha scartato immagini ritoccate
Aggiornato Ottobre 2026